Google Research 8 月 31 日发布了 TimesFM-3:时间序列预测基础模型的第三代,官方称它是「零样本多变量预测的 SOTA」。一句话概括这次发布:TimesFM 从「一次猜一条」升级到「一次猜一群」,而且不用训练、开箱即用。 本文先复述官方新闻和模型特点,再用我手头的测试数据实测其中三个特点——能测的用数据说话,没测到的只谈理论。
一、Google 发布了什么
8 月 31 日,Google Research 博客发布 TimesFM-3,作者是研究科学家 Ayush Jain 和 Rajat Sen。核心信息:
- TimesFM-3 是 TimesFM 系列首个原生支持多变量预测的模型。前两代(到 2025 年 9 月的 TimesFM-2.5)只能单变量——一次只看一条序列的历史猜一条;TimesFM-3 第一次能把多条相关序列、辅助特征一起喂进去,一次前向出全部预测。
- 33 亿参数,在超过 1 万亿个时间点的真实+合成语料上预训练。
- 零样本(zero-shot):不针对具体任务微调,直接拿权重就能预测新领域。
- 官方在 Gift-Eval、FEV-Bench、Time 三大公开榜单上测试,点预测和概率预测(分位数)指标都是预训练基础模型里第一。
- 模型已上 GitHub 和 HuggingFace,BigQuery 集成「数周内」到来。
说白了,这次发布解决的是一个老痛点:真实世界的预测问题天生就是多变量的。预测冰淇淋销量,光看历史销量不够,还得看蛋筒销量、客流、天气预报、促销日历、节假日。以前的 TimesFM 只能看一条销量曲线硬猜;TimesFM-3 把这些「陪跑的」都请进来了。
二、TimesFM-3 有什么特点
官方博客把技术细节讲得比较清楚,我提炼成四点:
特点 1:原生多变量,支持三类输入
- 多目标(multiple targets):同时预测多条相关序列,每条都出点预测和分位数预测。例:一起预测不同品牌的冰淇淋销量。
- 过去协变量(past covariates):只在历史里已知的特征,比如历史客流。
- 过去-未来协变量(past-future covariates):未来也已知的事件,比如计划好的促销、天气预报、节假日。这类特征用「lookahead」策略处理:每个 token 把当前 patch 和未来的已知 patch 拼在一起,让模型提前看到即将发生的已知信号。
特点 2:交替注意力,时间与变量两条线交织
架构还是 decoder-only Transformer,把连续时间点切成 32 点的 patch 做 token,但注意力换了玩法,在 2D 网格上交替跑两种:
- 因果时间注意力:token 横着看时间轴,只看自己序列的过去,防泄漏。
- 全变量注意力:token 竖着看同一时刻的所有序列,学跨序列相关性(比如 A 序列的促销如何带动 B 序列的销量)。
两种注意力隔层交替,把时间模式和跨序列关系拧在一起。
特点 3:非自回归,一次前向出整个预测
以前的 TimesFM 一个个 patch 地往外吐,慢、误差会累积。TimesFM-3 用 Contiguous Patch Masking:未来预测段全部放占位 token,目标序列和过去协变量的未来段 mask 掉(未来值未知),过去-未来协变量保持可见(已知信号),一次前向把所有 masked 的未来 patch 同时填完。无迭代循环,无自回归误差累积。
特点 4:九分位数,概率预测
每个目标序列每个时刻输出 9 个分位数(第 10 到第 90 百分位),拼成 80% 置信区间,给出完整的概率视图——不只告诉你「猜多少」,还告诉你「有多大把握」。
三、实测一:多变量联合预测 vs 各猜各的
这是特点 1 的直接检验:9 条一起猜,比 9 条各猜各的,到底强多少?
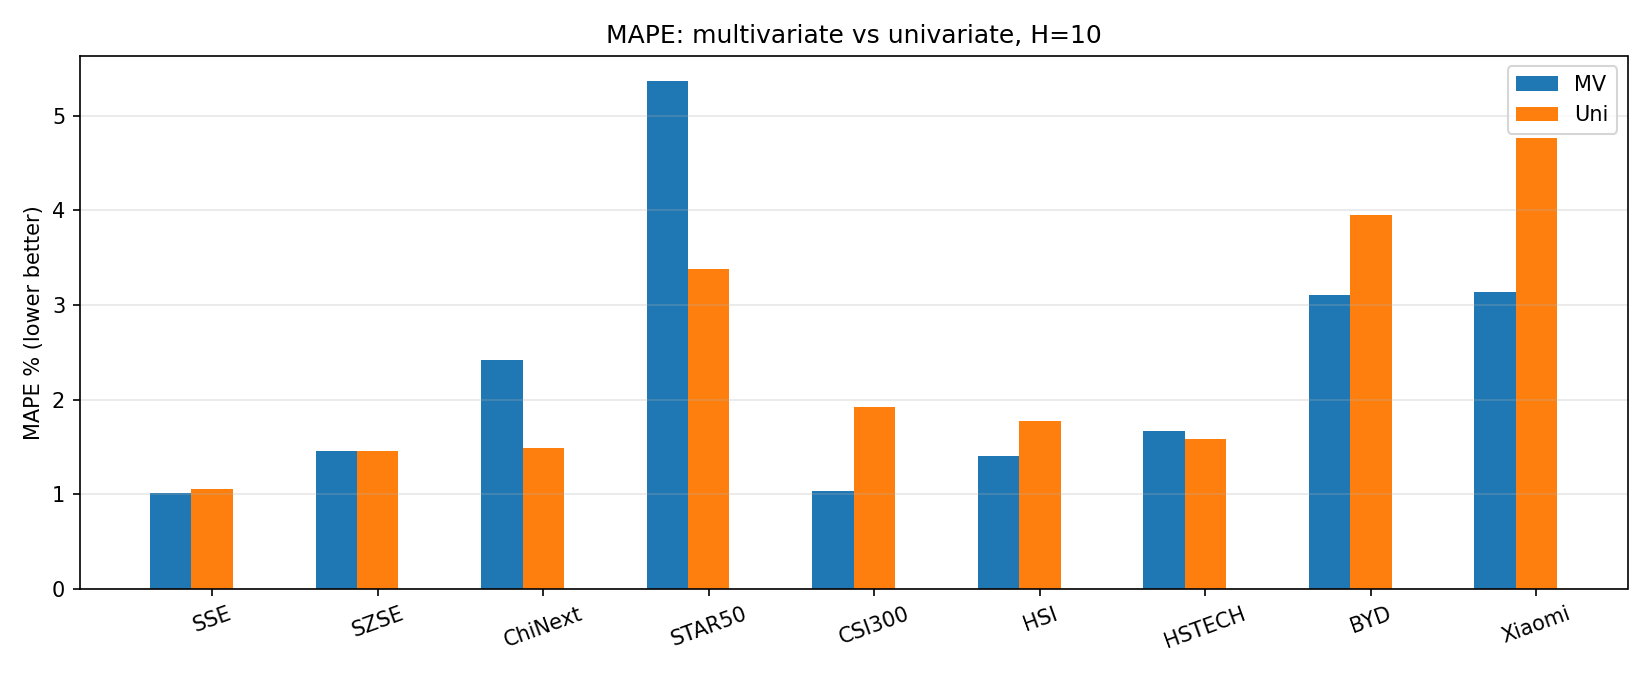
MAPE 是「平均猜错了百分之几」,柱子越矮越好。
十天尺度,9 条里 5 条「一起猜」赢了:沪深 300 的误差从各猜各的 1.92% 降到 1.04%,直接砍半;上证、恒指、比亚迪、小米也都是靠「看别的序列」降了误差。但科创 50 和创业板被带偏了——一起猜反而更差(5.36% vs 各猜各的 3.38%、2.42% vs 1.49%),小盘股跟大盘股的联动,模型没学明白。
拉长到 30 天,「一起猜」7 条翻回来赢;缩短到 5 天,「各猜各的」7 条反杀。规律很清楚:猜得越远,一起看越值钱;猜得越近,不如各管各的。 官方宣传的「多变量提升整体准确率」,在中长期 horizon 上兑现了,短期反而可能帮倒忙。
港股也沾了光:恒指十天误差 1.41%,各猜各的是 1.78%。用 A 股拉港股,方向是对的,就是短期内别指望立竿见影。
再和「抄昨天」的笨办法比——这才是预测评测里的扫地僧:
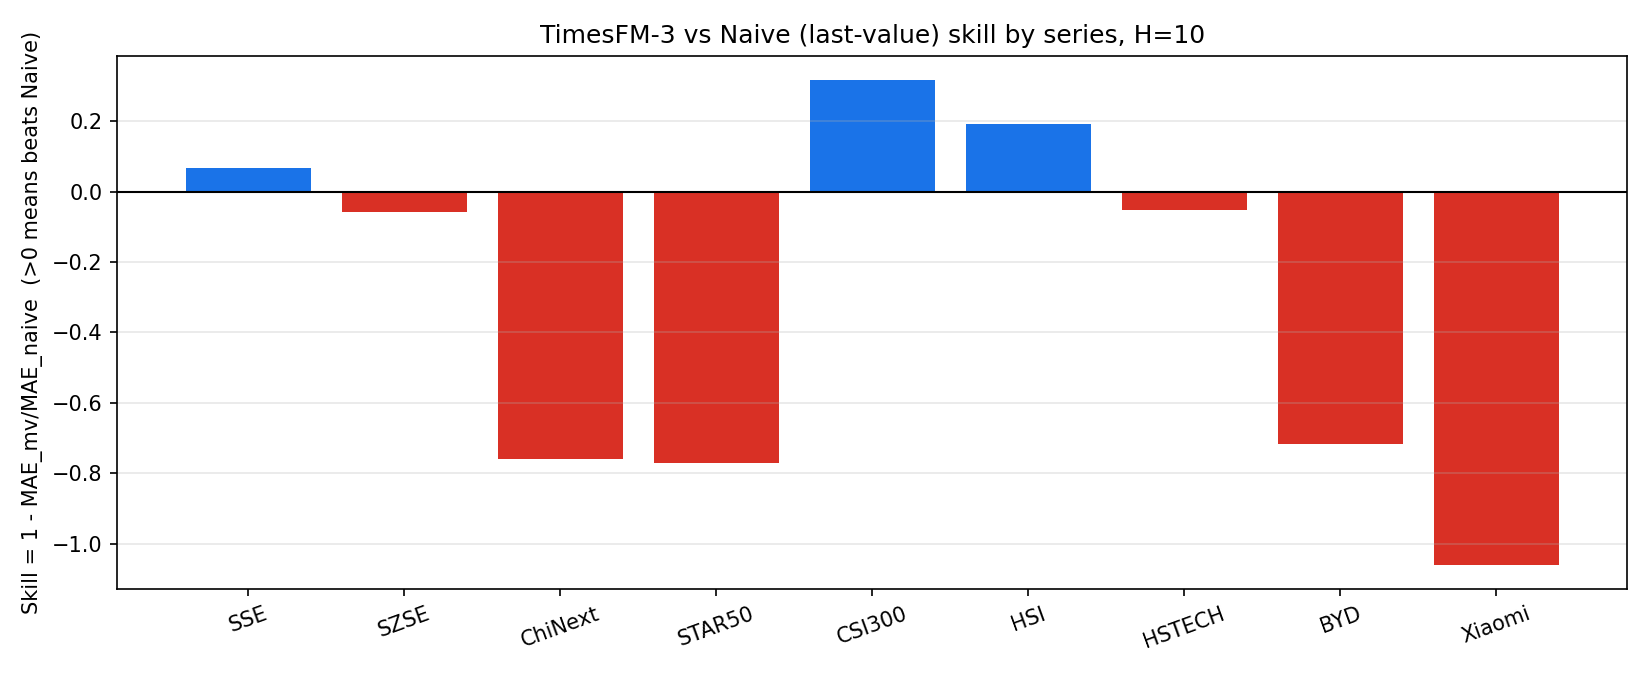
柱子在 0 以上才算赢。十天赢的 3 条:沪深 300(+0.32)、恒指(+0.19)、上证(+0.07)。输得最惨:小米(−1.06)、科创 50(−0.77)、创业板(−0.76)、比亚迪(−0.72)。三天尺度赢面是 5/9,五天最惨只剩 2/9。
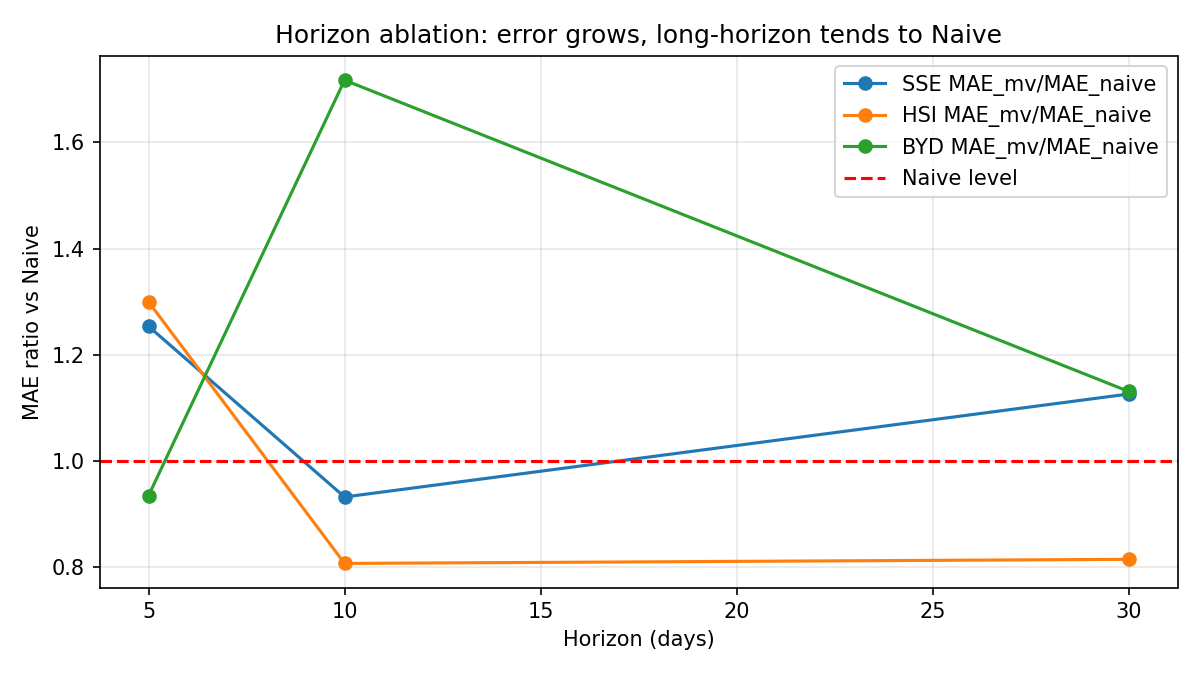
上图三条线是 MAE 相对 naive 的比值,虚线 1.0 是「抄昨天」水平。猜得越近,模型越吃亏;猜远了反而追回来一点——因为短期市场天天晃,「今天≈昨天」这条规律占上风,模型的平缓趋势线插不上手。
再看方向对不对(明天比今天涨还是跌):十天平均 57.8%——比扔硬币强,但强得有限。
小结:官方说的「多变量提升整体准确率」在中长期成立;但在 A 股港股这种高噪声场景,打赢「抄昨天」依然是少数派。榜上的第一,和你的行情,是两码事。
四、实测二:九分位数区间——盖得住,但太松
这是特点 4 的检验。模型每次给 9 个分位数,取 q10 和 q90 拼成「80% 把握」的区间,意思是「真实价格有八成机会落在这个带子里」。
十天实测:平均盖住了 92% 的真实价格,6 条序列干脆 100%——光看「盖没盖住」,它保守过头了:
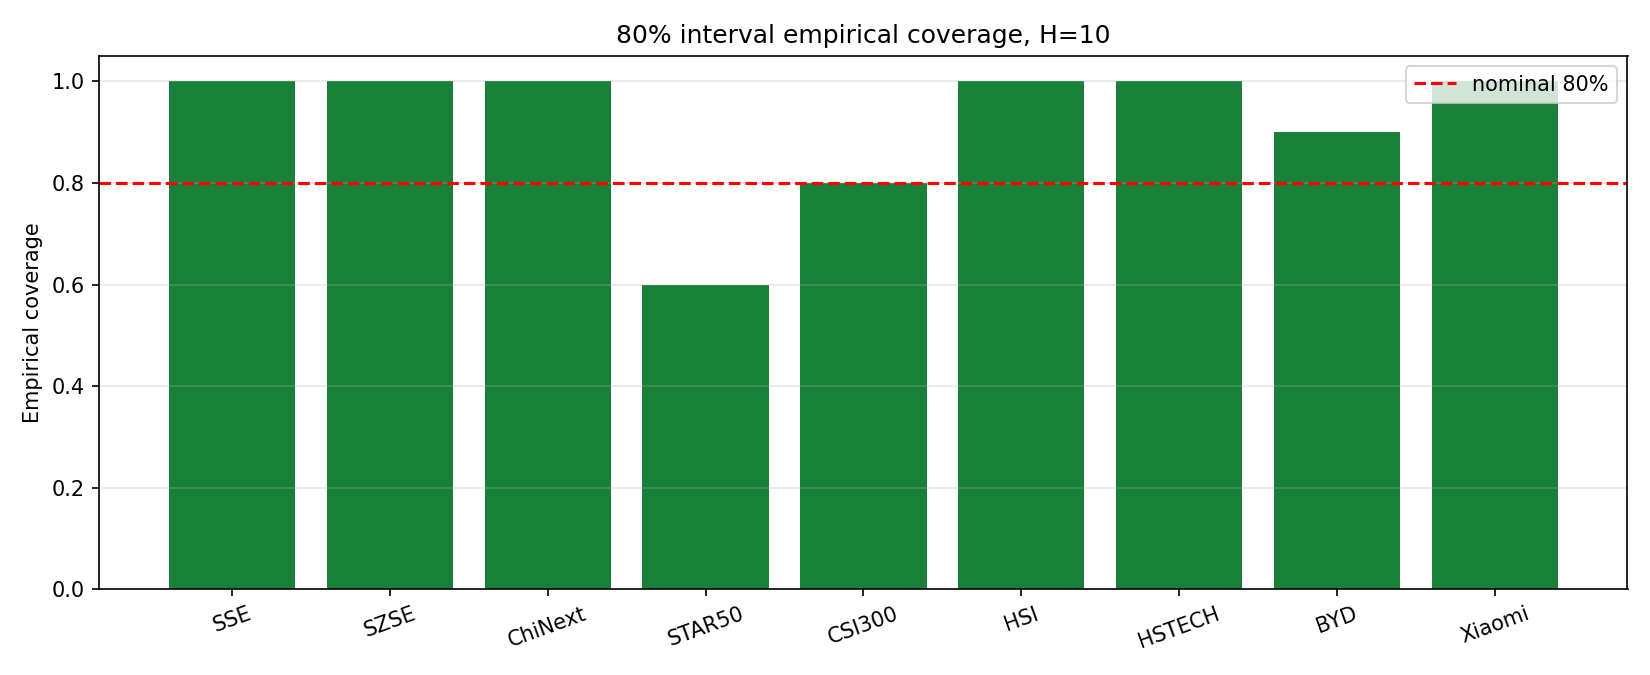
但把带子宽度和真实波动一比就露馅。十天里,模型给的区间平均宽度是实际波动幅度的 1.5 到 4.8 倍:
| 序列 | 区间平均宽度 | 实际波动幅度 | 宽度倍数 |
|---|---|---|---|
| 恒指 | 1362 点 | 483 点 | 2.8× |
| 沪深 300 | 187 点 | 98 点 | 1.9× |
| 上证 | 167 点 | 88 点 | 1.9× |
| 比亚迪 | 11.8 元 | 2.5 元 | 4.8× |
| 小米 | 5.0 元 | 1.7 元 | 3.0× |
这就像把渔网织得比池塘大好几倍,鱼当然跑不掉——网是够安全,可惜什么信息量都没有。 想拿它当风控线、定仓位,得自己重新收紧。
五、实测三:非自回归单次前向,速度确实快
这是特点 3 的检验。官方说「一次前向出整个预测,无迭代循环」,速度应该有优势。
实测对上了:9 条一起猜,一次前向 0.14 秒;各猜各的要跑 9 次、共 1.21 秒——快了将近 9 倍。批量开到 32 条时,每条只要 18.3 毫秒,显存占用 1.33GB,随便一张卡都塞得下。每天给几十个标的出一版预测,这个速度绰绰有余。
顺带说一个官方没重点讲、但实测很明显的现象:预测线太「直」了。
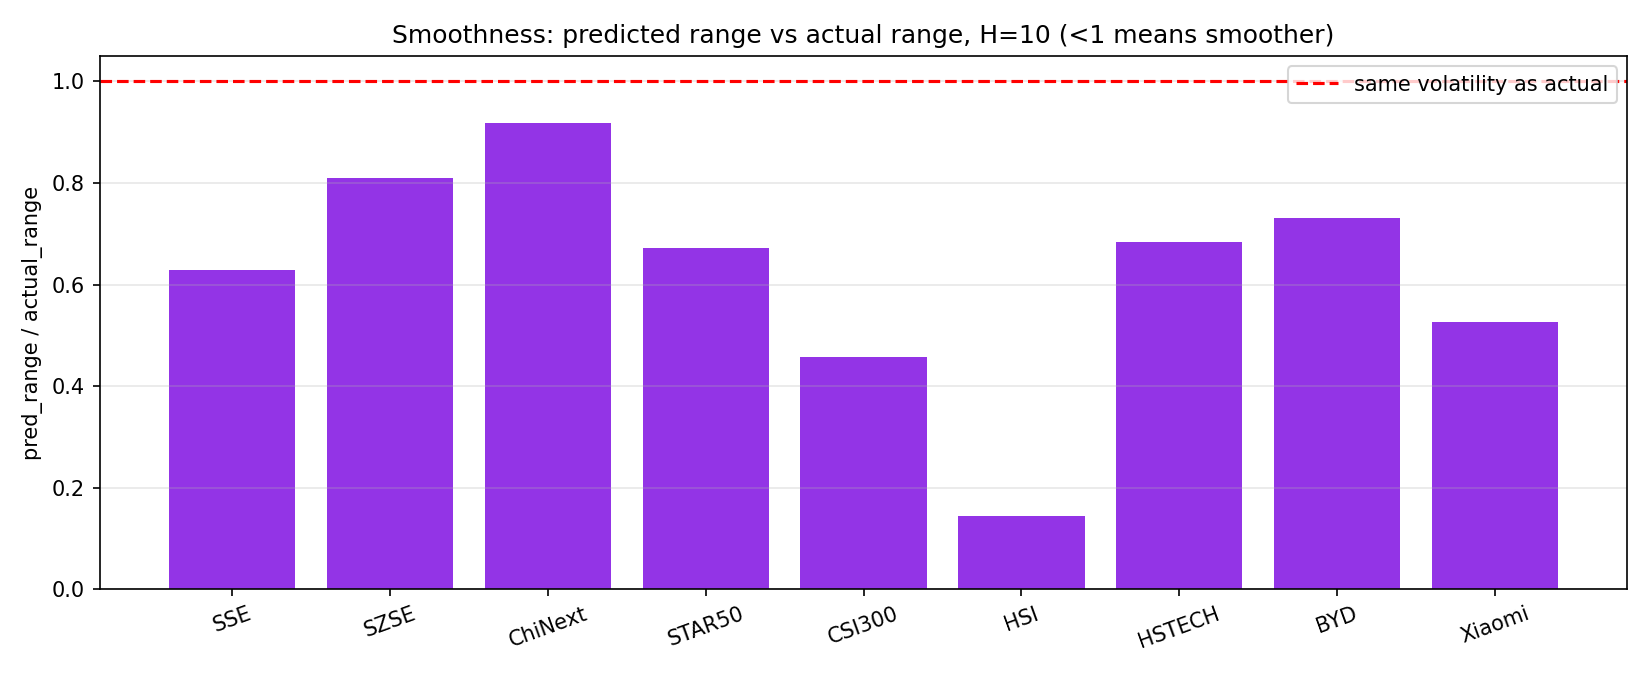
上图是预测波动幅度除以实际波动幅度,1.0 虚线是「和实际一样浪」。9 条全部小于 1,意味着预测全都比实际平缓:创业板 0.92 最接近,恒指只有 0.14——只演出实际波动的七分之一。下图更直观:黑线上蹿下跳,蓝虚线一路滑行。
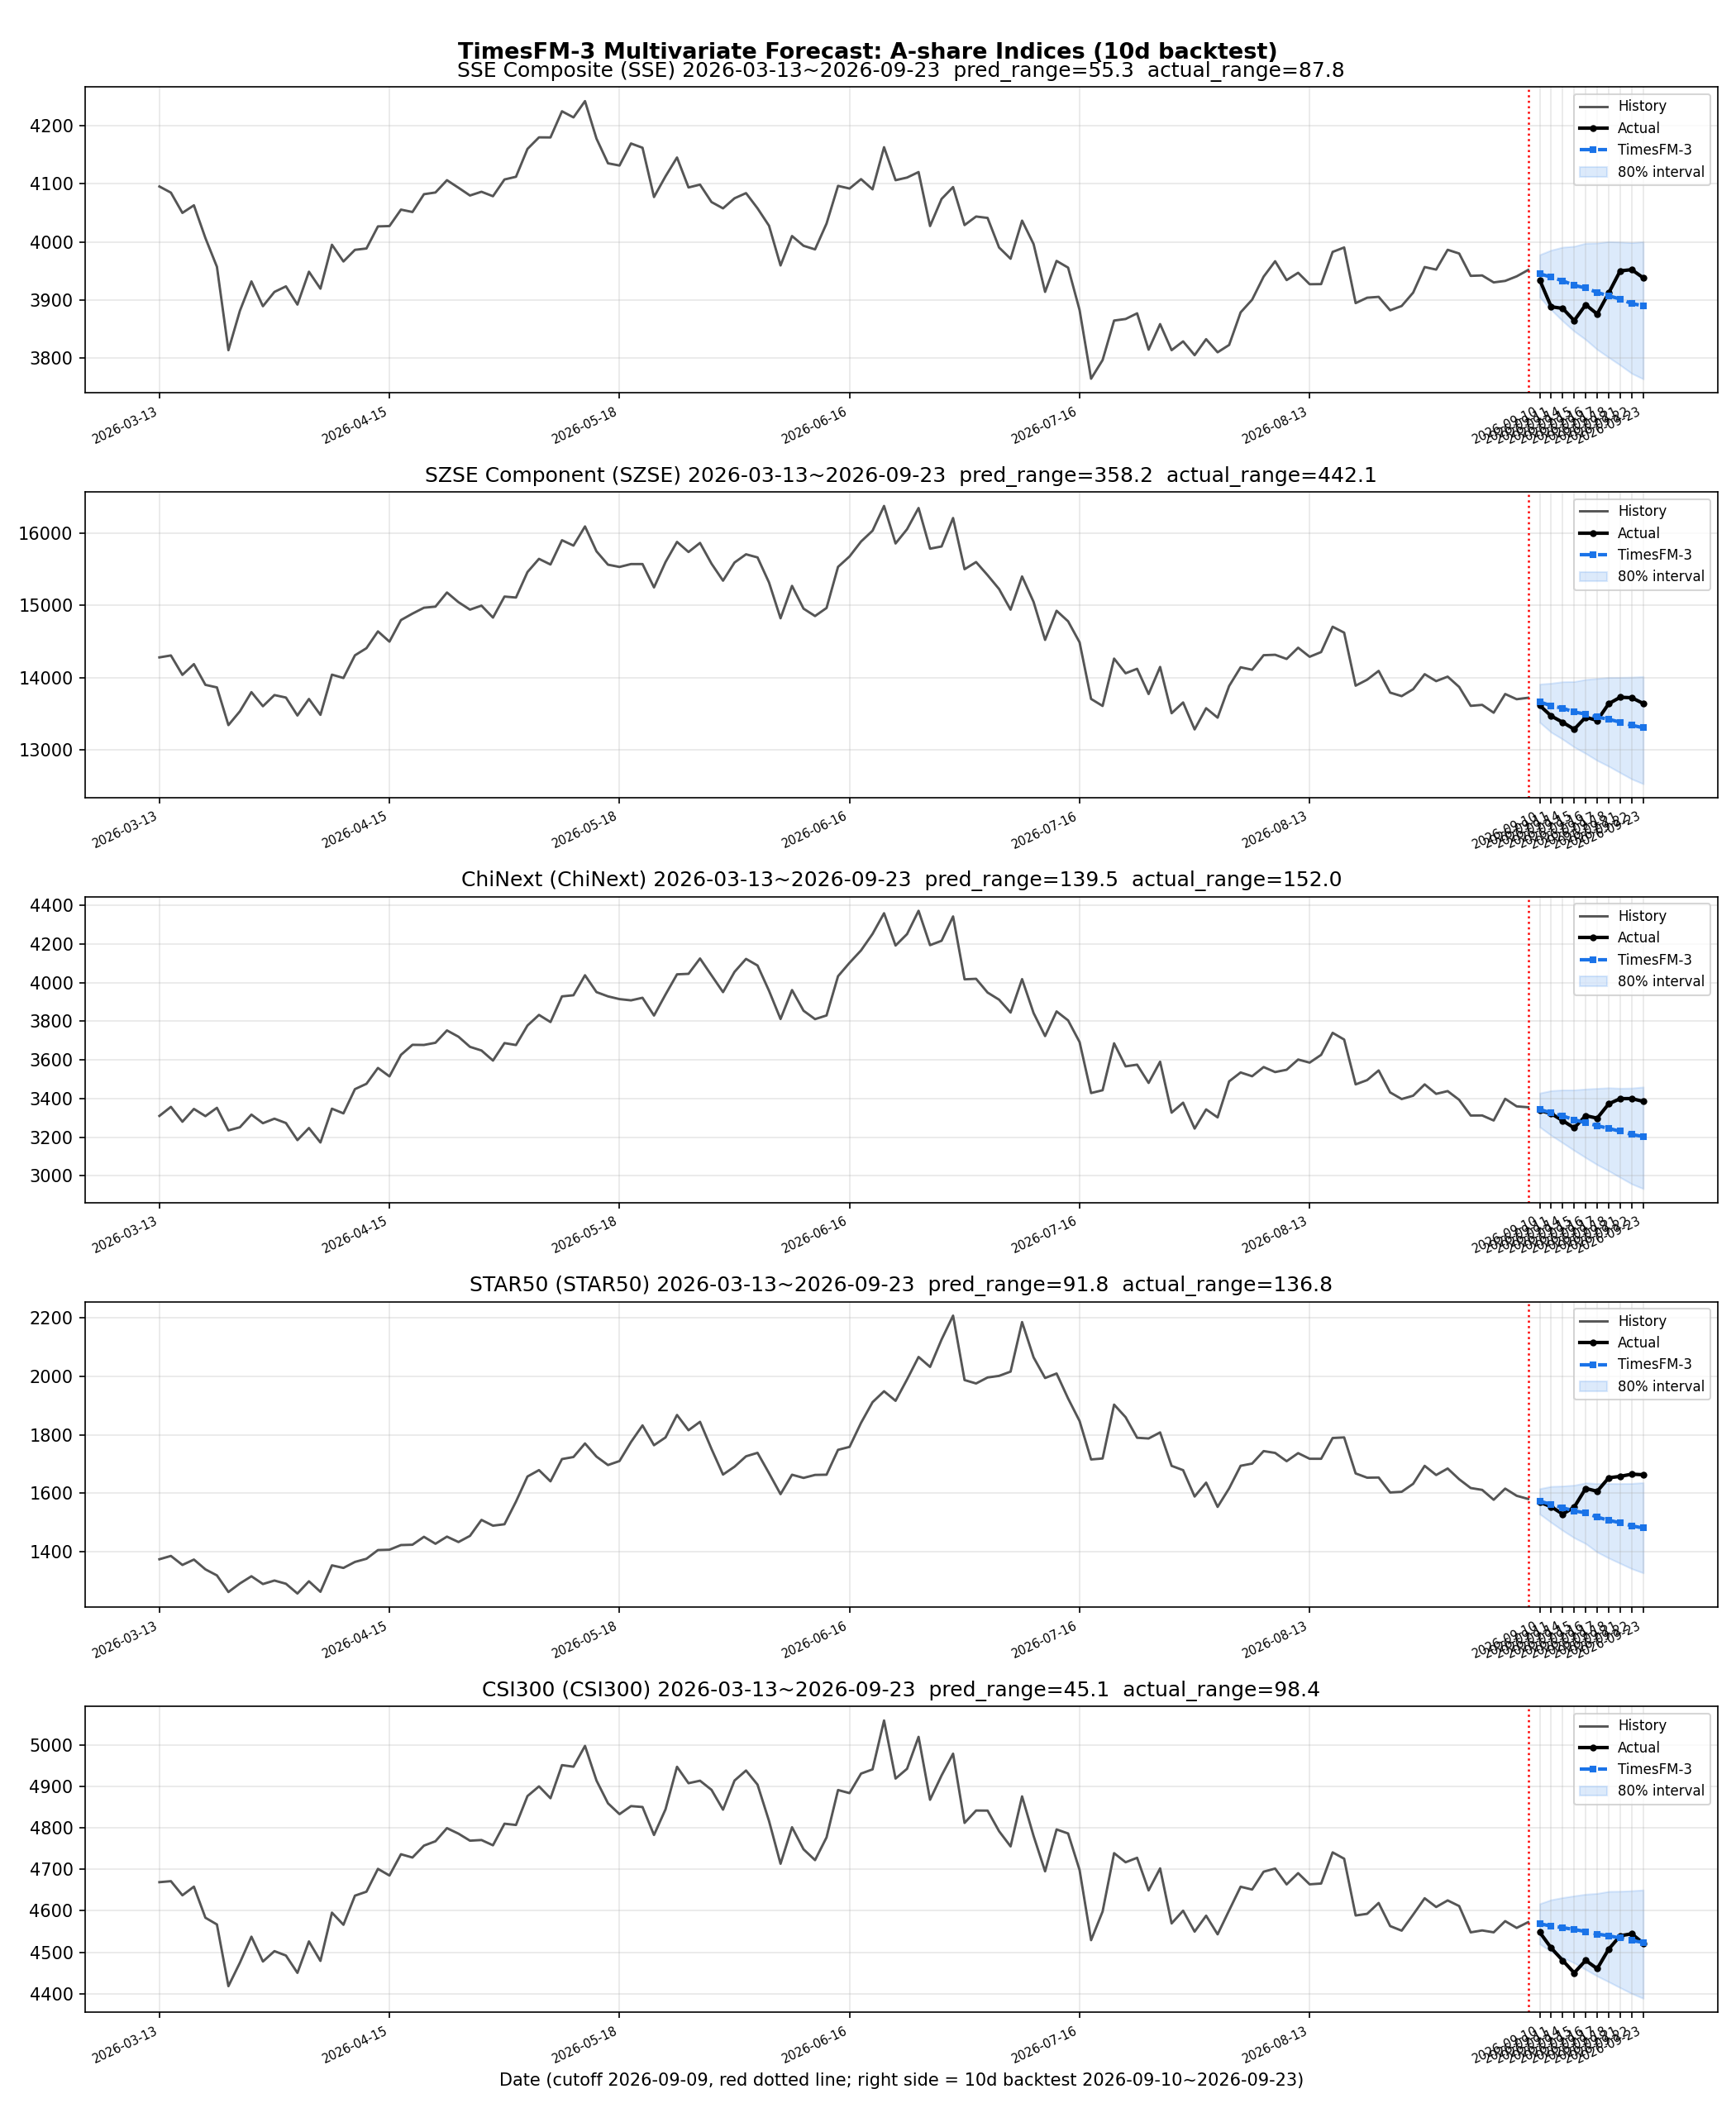
这不是 bug,是这类点预测模型的通病:往平均值收,涨跌都被熨平了。当趋势中枢的参考可以,当明天振幅的预报不行。
六、没测到的三个特点,只谈理论
上面三个特点找到了结合点、写了实测。剩下三个官方重点,测试数据里没有对应输入,我不编测试结果,只说理论上它们是什么、为什么可能有用。
过去协变量:历史里已知的辅助特征
官方例子是历史客流——只在历史里有、未来未知的特征。理论价值:客流和销量往往强相关,把客流的历史一起喂进去,模型能学到「客流涨则销量涨」的条件模式,比只看销量一条线信息更全。
过去-未来协变量:未来已知的事件信号
官方例子是促销日历、天气预报、节假日——历史和未来都已知的特征。这是 TimesFM-3 架构上最巧的一招(lookahead token:当前 patch 拼上未来 patch),理论上价值很高:它让模型「未卜先知」地把已知未来事件纳入预测。官方冰淇淋例子里,促销日历作为过去-未来协变量喂进去,模型学出「促销日销量抬升约 20%」,预测蓝线在每个促销日主动跳起来,而单变量红线无动于衷。对有明确事件日历的场景(零售促销、排班、电力负荷),这个特点可能比多变量本身更值钱——因为它引入的是确定性信息,不是模型猜的相关性。
三大榜单第一:Gift-Eval、FEV-Bench、Time
官方说在这三个榜单上,TimesFM-3 在点预测和概率预测指标上都是预训练基础模型平均排名第一,且单变量模式就已经匹配或超过竞品,切到全多变量模式再上一个台阶。它在用电量、气温、销量这类有规律的序列上大概率成立,但你的行情是另一场考试,本文第三节的实测就是那场考试的成绩单。
七、对账官方说法,以及那道许可证
把官方博客的几句话和实测对一对:
| 官方说法 | 实测对账 |
|---|---|
| 多变量提升整体准确率 | 部分对上:中长期(10/30 天)多数序列一起猜更准;短期(5 天)反而各猜各的更好 |
| 一次前向出整个预测 | 对上了:9 条 0.14 秒,比各猜各的快 9 倍 |
| 概率预测提供完整不确定性视图 | 形式上有,实测偏松:区间盖住 92%,但宽度是实际波动的 1.5~4.8 倍 |
| 三大榜单第一 | 本次未复现,不评论 |
还有一道不在模型里、却会拦住很多人的门槛:TimesFM 3.0 的权重用的是非商用许可(timesfm-non-commercial-license-v1.0),只许非商业用途。代码是 Apache-2.0,2.5 版及以前的权重也是,唯独 3.0 权重卡了这一道。想把它接进生产系统去赚钱的,先去读许可证。
八、写在最后
Google 这次发布,把时间序列基础模型从「单变量时代」推进到「多变量时代」,架构上的三板斧——交替注意力、非自回归单次前向、九分位数概率输出——都有清晰的技术动机。用测试数据实测三个特点:两个兑现了(多变量中长期更准、速度确实快),一个打了个折扣(区间盖得住但偏松);没测到的三个(协变量、事件日历、榜单),只谈理论不编数据。
有时候打败 330M 参数、1 万亿个时间点的,就是一句 pred = last_value。但这个基线不画图、不吐区间、不告诉你「我有 80% 的把握」——它只是安静地把昨天抄了一遍,然后在这个测试里,十天赢了三条。
榜单第一是真的,你的行情是另一场考试。而这场考试里,最像样的对手依然是那句写进教材的废话:明天,大概率还是今天的样子。